指标模型
10 分钟阅读
简要概述
兼容 prometheus
使用 OTLP 模型传输数据,然后导出到现有系统中,数据模型可以明确转换为 Prometheus Remote Write 协议,而不会丢失数据。
已明确三种保持语义的指标数据转换方式,这些转换在构建指标采集系统时能有效控制成本、保障可靠性并优化资源配置,指标数据模型支持在SDK内部数据生成阶段,或通过收集器内的再处理阶段实现以下转换:
- 时序重聚合
高频采集的指标数据可被重新聚合为更长的时间间隔,从而生成低分辨率时间序列数据用于预计算或替代原始指标数据。
- 空间重聚合
对于包含冗余属性的指标数据,可通过重聚合操作生成属性更精简的指标数据集; 对不需要的属性的指标可以重新聚合,以丢弃这些属性,降低存储空间。
- 增量转累计
采用增量时间性的指标数据在输入输出时,可避免客户端维护高基数状态。通过使用增量数据,下游服务既可承担转换为累计时间序列的计算成本,也可直接计算速率值以规避转换开销。
示例 JSON 结构
{
  "resourceMetrics": [
    {
      "resource": {
        "attributes": [
          {
            "key": "service.name",
            "value": {
              "stringValue": "my.service"
            }
          }
        ]
      },
      "scopeMetrics": [
        {
          "scope": {
            "name": "my.library",
            "version": "1.0.0",
            "attributes": [
              {
                "key": "my.scope.attribute",
                "value": {
                  "stringValue": "some scope attribute"
                }
              }
            ]
          },
          "metrics": [
            {
              "name": "my.counter",
              "unit": "1",
              "description": "I am a Counter",
              "sum": {
                "aggregationTemporality": 1,
                "isMonotonic": true,
                "dataPoints": [
                  {
                    "asDouble": 5,
                    "startTimeUnixNano": "1544712660300000000",
                    "timeUnixNano": "1544712660300000000",
                    "attributes": [
                      {
                        "key": "my.counter.attr",
                        "value": {
                          "stringValue": "some value"
                        }
                      }
                    ]
                  }
                ]
              }
            },
            {
              "name": "my.gauge",
              "unit": "1",
              "description": "I am a Gauge",
              "gauge": {
                "dataPoints": [
                  {
                    "asDouble": 10,
                    "timeUnixNano": "1544712660300000000",
                    "attributes": [
                      {
                        "key": "my.gauge.attr",
                        "value": {
                          "stringValue": "some value"
                        }
                      }
                    ]
                  }
                ]
              }
            }
          ]
        }
      ]
    }
  ]
}
数据结构
ResourceMetrics
// 一个 ResourceMetrics 表示「某个资源(例如一台主机或容器)」下的一组指标
message ResourceMetrics {
  // 与此消息中指标相关联的资源信息
  // 如果该字段未设置,则表示无法确定任何资源信息
  opentelemetry.proto.resource.v1.Resource resource = 1;

  // 属于该资源的指标集合列表。
  // 每个元素表示一个来自特定 Instrumentation Scope 的指标集。
  repeated ScopeMetrics scope_metrics = 2;
}
Resource
// 资源信息。
message Resource {
  // 描述资源的属性集合。
  // 属性键必须唯一(不允许存在重复键)。
  //
  // 属性值建议遵循以下规则:
  // - 不应包含空值
  // - 不应包含字节类型
  // - 不应包含非字符串数组、布尔数组、整数数组或浮点数组的数组类型
  // - 不应包含 kvlist 类型
  // 接收端在处理违反这些规则的属性时行为可能不可预测。
  // 这些限制可能会在小版本中改变。
  // 限制来源于 OpenTelemetry 规范:
  // https://github.com/open-telemetry/opentelemetry-specification/blob/v1.47.0/specification/common/README.md#attribute
  repeated opentelemetry.proto.common.v1.KeyValue attributes = 1;

  // 被丢弃的属性数量。如果值为 0,则表示没有属性被丢弃。
  uint32 dropped_attributes_count = 2;
ScopeMetrics
// 一组由某个 Instrumentation Scope(采集作用域)生成的指标集合
message ScopeMetrics {
  // 此消息中指标所属的 “Instrumentation Scope” 信息。
  // 如果该字段未设置,则语义上等同于 “Instrumentation Scope 名称为空(unknown)”。
  opentelemetry.proto.common.v1.InstrumentationScope scope = 1;

  // 一个指标列表,这些指标都来源于同一个 Instrumentation Library(采集库/模块)。
  repeated Metric metrics = 2;
}
Scope
// InstrumentationScope 表示采集器(instrumentation)的作用域信息
// 例如完整名称和版本号。
message InstrumentationScope {
  // 表示采集器作用域的名称。
  // 代表 SDK 或库的名称,例如 opentelemetry-go、grpc-client 等。
  string name = 1;

  // 定义采集器作用域的版本号。
  // 代表 SDK 或库的版本号,例如 1.47.0。
  string version = 2;

  // 描述作用域的附加属性 [可选]。
  // 属性键必须唯一(不允许存在重复键)。
  repeated KeyValue attributes = 3;

  // 被丢弃的属性数量。
  // 属性可能因为键过长或属性数量过多而被丢弃。
  // 如果值为 0,则表示没有属性被丢弃。
  uint32 dropped_attributes_count = 4;
}
Metric
// 表示一个指标(Metric)实体的定义。
// 每个 Metric 代表一种可测量的数据,例如请求时延、CPU 使用率、网络吞吐量等。
message Metric {
  // 指标的名称。
  string name = 1;

  // 指标的描述信息,可用于文档或可视化展示,帮助人类理解指标含义。
  string description = 2;

  // 指标值的度量单位(可选)。
  // 需遵循 https://unitsofmeasure.org/ucum.html 标准定义,
  // 例如 "s"(秒)、"By"(字节)、"1"(无单位)等。
  string unit = 3;

  // 指标的数据类型(聚合类型和取值形式)。
  // 该字段是一个 oneof(互斥字段),即同时只能出现一个。
  // 用于决定该指标属于哪种类型:
  // - Gauge(仪表盘):表示瞬时值,例如当前内存使用量、CPU 使用率等。
  // - Sum(总和):表示累计值,例如请求总次数、错误总次数等。
  // - Histogram(直方图):表示分布统计,例如请求时延分布、响应大小分布等。
  // - ExponentialHistogram(指数直方图):与直方图类似,但用于处理大范围值。
  // - Summary(摘要):表示统计摘要,例如 95% 响应时间、99% 响应时间等。
  oneof data {
    Gauge gauge = 5;
    Sum sum = 7;
    Histogram histogram = 9;
    ExponentialHistogram exponential_histogram = 10;
    Summary summary = 11;
  }
}
指标数据点
Gauge
// 表示一种标量指标类型(scalar metric),它始终为每个数据点导出当前值(current value)。
// 当指标的聚合方式未知(unknown)时,应使用 Gauge。
//
// Gauge 不支持不同的聚合时间特性(Aggregation Temporality)。
// 因为其聚合方式未知,数据点之间无法通过相同的聚合逻辑进行合并,
// 因此 AggregationTemporality 字段不会包含在 Gauge 中。
// 同样地,这也意味着 "StartTimeUnixNano" 字段对 Gauge 数据点无效(被忽略)。
message Gauge {
  // 时间序列数据点。
  // 注意:同一时间戳可能包含多个数据点,它们具有不同属性(attributes)。
  repeated NumberDataPoint data_points = 1;
}
一组数据点,表示在给定时间的采样值,每个数据点包含一组独立的属性名称值对。
指标流中的一个点表示给定时间窗口内的最后采样事件,一般用于以下场景:
- 采样值(例如当前CPU温度)
- 对值进行采样时的时间戳(time_unix_ano)
- 时间戳(start_time_unix_ano),它最能代表可以记录测量的第一个可能时刻。这通常设置为度量收集系统启动时的时间戳。
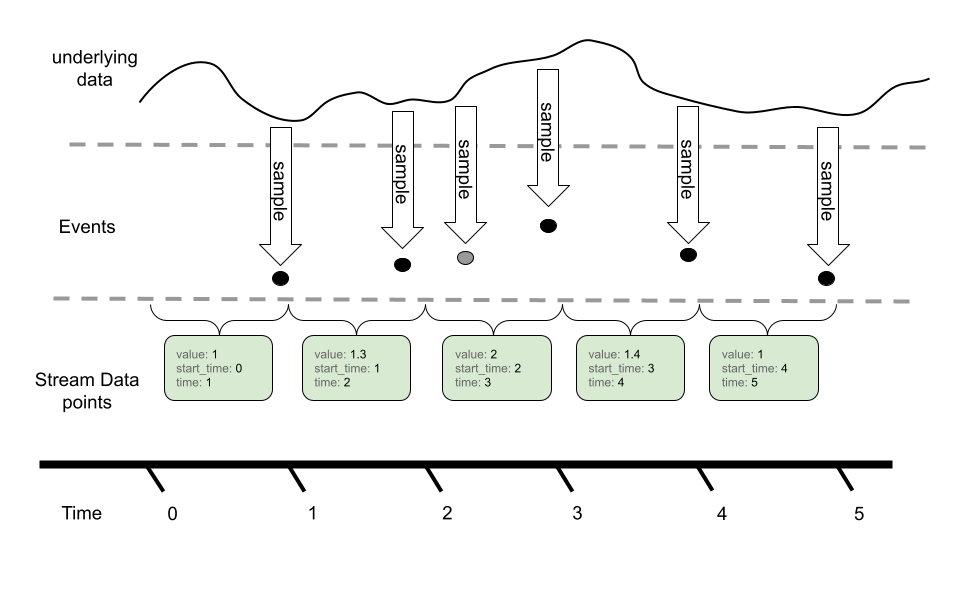
使用 Gauge 进行采样的基本时间序列,在给定的时间间隔内进行多次采样,但只有最后一个值通过 OTLP 在指标流中报告。
区别于 Sum 该不提供聚合语义,而是在执行时间窗口或调整精度等操作时使用“最后样本值”。
可以通过转换为直方图或其他度量类型来聚合度量。默认情况下不会执行这些操作,并且需要直接的用户配置。
Sum
// Sum 表示标量指标类型(scalar metric),它是一个时间区间内所有上报测量值的总和。
message Sum {
  // 时间序列数据点。
  // 注意:同一时间戳可能包含多个数据点,它们具有不同属性(attributes)。
  repeated NumberDataPoint data_points = 1;

  // 描述聚合器的时间特性:
  // - DELTA: 自上次报告以来的增量
  // - CUMULATIVE: 自固定起始时间以来的累计值
  AggregationTemporality aggregation_temporality = 2;

  // 指示该 Sum 是否为单调递增(monotonic)。
  // 通常计数器指标(如网络字节数、请求总数)是单调递增的。
  bool is_monotonic = 3;
}
一组数据点,聚合方式为增量(Delta)或累积(Cumulative),每个数据点包含独立的属性名称值对。
在各种用例中,具体使用哪种聚合方式存在各种权衡,例如:
- 检测进程重新启动(累积值重新由 0 开始)
- 计算费率(计算增量,当前时间指标值 - 前一个时间指标值)
- 基于推送与拉取的指标报告
OTLP 支持这两种模型,并允许 API、SDK 和用户为其用例确定最佳折衷方案。
- 对指标做临时增量(Delta)
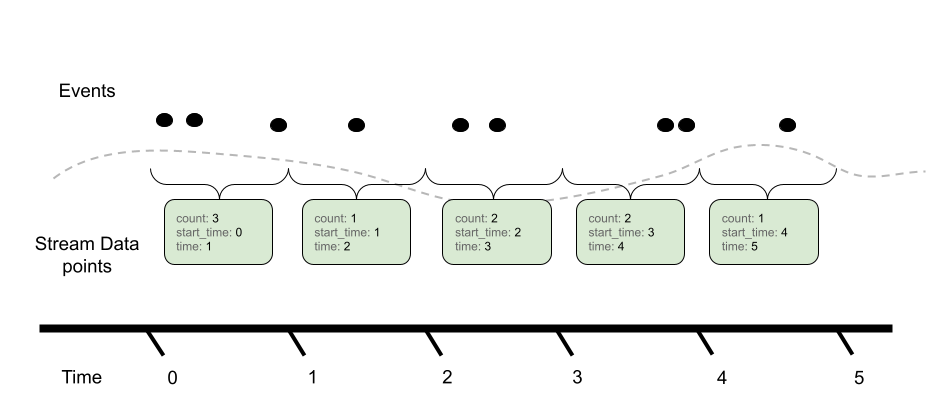
当聚合时间性是增量时(类似 prometheus rate 计算函数),指标流的时间窗口没有重叠,值不会出现负数。
- 对指标做临时累积(Cumulative)
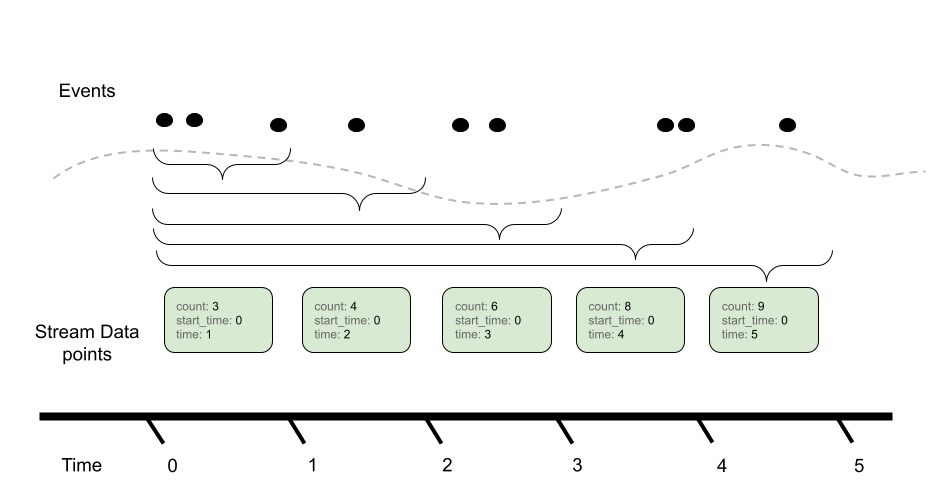
当聚合时间性是累积时,计算自应用启动以来的时间窗口(起始,结束])所有值的求和,值为单调递增,也就是当前值不会小于前一个。
Histogram
// Histogram 表示一种指标类型,它在一个时间区间内对所有上报测量值进行直方图聚合。
message Histogram {
  // 时间序列数据点。
  // 注意:同一时间戳可能包含多个数据点,它们具有不同属性(attributes)。
  repeated HistogramDataPoint data_points = 1;

  // 描述聚合器的时间特性:
  // - DELTA: 自上次报告以来的增量
  // - CUMULATIVE: 自固定起始时间以来的累计值
  AggregationTemporality aggregation_temporality = 2;
}
直方图以压缩格式记录测量的总体,它将一组事件捆绑成具有总体事件计数和所有事件的总和。
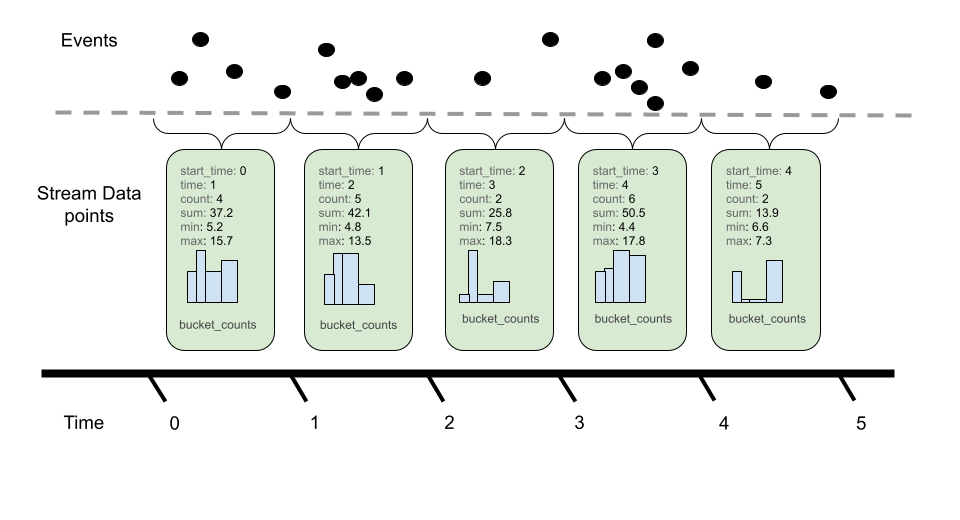
指标会自动压缩聚合,默认以 “bucket” “sum” “count” 三中类型组成:
- “count” 该指标被观测到的次数,计数累计值
- “sum” 该指标被观测到的值总和,值累计总和
- “bucket” 该指标被观测到的值被放到一个预先定义好值边界 (le1, le2] 范围内,计数累计值
以 otelgrpc 中指标 “rpc.server.duration” 为示例,并以 prometheus 风格导出:
# HELP rpc_server_duration_milliseconds
# TYPE rpc_server_duration_milliseconds histogram
rpc_server_duration_milliseconds_bucket{rpc_grpc_status_code="0",rpc_method="Test",rpc_system="grpc",le="0"} 0
rpc_server_duration_milliseconds_bucket{rpc_grpc_status_code="0",rpc_method="Test",rpc_system="grpc",le="5"} 0
......
rpc_server_duration_milliseconds_bucket{rpc_grpc_status_code="0",rpc_method="Test",rpc_system="grpc",le="10000"} 1
rpc_server_duration_milliseconds_bucket{rpc_grpc_status_code="0",rpc_method="Test",rpc_system="grpc",le="+Inf"} 1
rpc_server_duration_milliseconds_sum{rpc_grpc_status_code="0",rpc_method="Test",rpc_system="grpc"} 369
rpc_server_duration_milliseconds_count{rpc_grpc_status_code="0",rpc_method="Test",rpc_system="grpc"} 1
Bucket 的上界是包含的(上界为 +Inf 的情况除外),而 Bucket 的下界是互斥。也就是说,bucket 表示大于其下界且小于或等于其上界的值的数量。
ExponentialHistogram
// ExponentialHistogram 表示一种指标类型,它在一个时间区间内对所有上报的 double 值进行指数直方图聚合。
message ExponentialHistogram {
  // 时间序列数据点。
  // 注意:同一时间戳可能包含多个数据点,它们具有不同属性(attributes)。
  repeated ExponentialHistogramDataPoint data_points = 1;

  // 描述聚合器的时间特性:
  // - DELTA: 自上次报告以来的增量
  // - CUMULATIVE: 自固定起始时间以来的累计值
  AggregationTemporality aggregation_temporality = 2;
}
Summary
// Summary 指标类型用于传递分位数汇总。
// Summary 数据点不能总是以有意义的方式合并。
// 虽然在某些应用场景下有用,但建议新应用使用 Histogram。
// Summary 类型没有 aggregation_temporality 字段。
// 因为 SummaryDataPoint 的 count 和 sum 字段被假定为累计值(cumulative)。
message Summary {
  // data_points:
  // 时间序列数据点。
  // 注意:同一时间戳可能包含多个数据点,它们具有不同属性(attributes)。
  repeated SummaryDataPoint data_points = 1;
}
摘要指标数据点用于传递分位数摘要信息,例如"我的HTTP服务器的第99百分位延迟是多少",与 OpenTelemetry 中的其他点类型不同,摘要点通常无法以有意义的方式进行合并,不建议在新应用中使用此点类型,其存在主要用于兼容其他格式。
摘要包含以下组成部分:
一组数据点,每个数据点包含:
- 独立的属性名值对集合
- 数值采样时间戳(time_unix_nano)
- (可选)表示摘要观测收集开始时间的时间戳(start_time_unix_nano)
- 数据点总体中的观测值数量计数
- 总体中各数值的总和
- 一组严格递增的分位数值,其中每个分位数包含:
- 分布的分位数,取值范围为[0.0, 1.0]。例如,数值0.9表示第90百分位
- 该分位数对应的数值,必须为非负数
特别说明:
- 0.0 和 1.0 分位数分别定义为等于最小值和最大值
- 分位数值不需要代表 start_time_unix_nano 到 time_unix_nano 期间观测到的数值,通常应基于最近时间窗口(通常是最近5-10分钟)计算得出
AggregationTemporality
// 用于定义指标聚合器(aggregator)如何报告聚合后的数值,它描述了这些数值与聚合时间区间的关系。
enum AggregationTemporality {
  // UNSPECIFIED 表示未指定的聚合时间性,作为默认值使用,但不能在实际场景中使用。
  AGGREGATION_TEMPORALITY_UNSPECIFIED = 0;

  // DELTA(增量模式)表示聚合器在每个时间区间内报告自上次报告以来的变化量。
  // 每次上报的指标值仅代表本次测量周期内的数据,与历史无关。
  //
  // 即:每次上报的度量是“本周期新增的值”,周期之间互不重叠。
  //
  // 举例:假设系统统计每秒收到的请求数量,并以 DELTA 模式上报。
  //
  //   1. 系统在时间 t₀ 启动。
  //   2. 收到一个请求,计数 +1。
  //   3. 又收到两个请求,累计 +2。
  //   4. 经过 1 秒(t₀ ~ t₀+1),系统上报本周期请求总数 = 3。
  //   5. 下个周期(t₀+1 ~ t₀+2),又收到 2 个请求。
  //   6. 上报值为 2(即这一秒内的增量)。
  //
  // DELTA 模式下,指标值仅反映当前周期内的数据变化。
  AGGREGATION_TEMPORALITY_DELTA = 1;

  // CUMULATIVE(累积模式)表示聚合器报告自固定起始时间以来的累积变化量。
  // 即:每次上报的值包含从开始时间起到当前时间为止的所有测量结果。
  //
  // 这种模式下,采集端必须维护“自启动以来”的状态;
  // 如果状态丢失(例如程序重启),则必须重置为新的起始时间。
  //
  // 举例:系统统计自启动以来累计收到的请求数量,并以 CUMULATIVE 模式上报。
  //
  //   1. 系统在时间 t₀ 启动。
  //   2. 收到 3 个请求。
  //   3. 经过 1 秒(t₀ ~ t₀+1),上报总请求数 = 3。
  //   4. 下一个周期又收到 2 个请求。
  //   5. 经过 1 秒(t₀ ~ t₀+2),上报总请求数 = 5。
  //   6. 系统故障导致状态丢失。
  //   7. 系统在时间 t₁ 恢复,重新统计。
  //   8. 收到 1 个请求。
  //   9. 新的报告周期上报总请求数 = 1(从 t₁ 开始重新计算)。
  //
  // 注意:
  // 即使在每次上报周期只包含增量时,也可以使用 CUMULATIVE;
  // 但通常不推荐这样做,因为像 Prometheus 这种系统依赖 `start_time`
  // 来判断聚合重置的时间,如果使用不当会造成指标歧义。
  AGGREGATION_TEMPORALITY_CUMULATIVE = 2;
}
DataPointFlags
enum DataPointFlags {
  // 枚举的零值(默认值)。不应直接用于比较。
  // 如果需要检测标志,应使用按位“与”运算符和对应的掩码(如上例)。
  DATA_POINT_FLAGS_DO_NOT_USE = 0;

  // 表示该 DataPoint 有效,但没有记录实际数值。
  // 当需要明确表示数据缺失时应使用此标志,
  // 类似于 Prometheus 中的“陈旧标记(staleness marker)”概念。
  DATA_POINT_FLAGS_NO_RECORDED_VALUE_MASK = 1;

  // 位 2–31 保留,供未来扩展使用。
}
Exemplar
// Exemplar 表示一个示例(采样的输入测量值)。
// 它不仅包含测量值本身,还记录了测量时的环境信息,
// 例如在记录该示例时处于活动状态的 Span ID 和 Trace ID
message Exemplar {
  // 一组键值对(KeyValue),表示被聚合器过滤掉但仍被记录下来的属性。
  // 只有那些被聚合器过滤掉的属性才应包含在此字段中。
  repeated opentelemetry.proto.common.v1.KeyValue filtered_attributes = 7;

  // 表示该示例被记录时的精确时间。
  fixed64 time_unix_nano = 2;

  // 记录的测量值。
  // Exemplar 中只允许存在一个值字段(通过 oneof 定义)。
  // 若所有值字段都为空,则该 Exemplar 被视为无效。
  oneof value {
    double as_double = 3; // 浮点型测量值
    sfixed64 as_int = 6;  // 整型测量值
  }

  // (可选)该示例对应追踪的 Span ID。
  // 如果测量未在追踪中记录,或该追踪未被采样,则 span_id 可能缺失。
  bytes span_id = 4;

  // (可选)该示例对应追踪的 Trace ID。
  // 如果测量未在追踪中记录,或该追踪未被采样,则 trace_id 可能缺失。
  bytes trace_id = 5;
}
NumberDataPoint
// NumberDataPoint 是时间序列 (timeseries) 中的一个单独数据点,
// 用于描述某个指标(metric)在时间变化中的标量值 (scalar value)。
message NumberDataPoint {
  // 表示该数据点的标签(key/value 对),用来唯一标识某个时间序列(Timeseries)。
  // 有以下约束说明:
  // 1. 每个数据点的标签(key/value 对)必须唯一。
  // 2. value 不应为空。
  // 3. value 不应为 bytes、kvlist 类型。
  // 4. 允许的数组类型仅限 array<string>, array<bool>, array<int>, array<double>。
  // The restrictions take origin from the OpenTelemetry specification:
  // https://github.com/open-telemetry/opentelemetry-specification/blob/v1.47.0/specification/common/README.md#attribute.
  repeated opentelemetry.proto.common.v1.KeyValue attributes = 7;

  // 可选字段
  // 数据点的起始时间(纳秒精度),表示聚合周期开始时间
  // 在累计型(Cumulative)指标中非常重要,用于标识统计区间的开始点
  // 在瞬时型(Gauge)中通常可忽略
  fixed64 start_time_unix_nano = 2;

  // 必填字段
  // 数据点的采样时间戳(纳秒精度)
  // 表示该数值被观测的时刻
  fixed64 time_unix_nano = 3;

  // 实际的指标值,二选一,可以是:
  // 1. 浮点数
  // 2. 有符号整数(sfixed64)
  oneof value {
    double as_double = 4;
    sfixed64 as_int = 6;
  }

  // 可选字段
  // 样本点,用于提供与此数据点相关的具体观测样本
  // 例如 Prometheus 的 exemplar 概念:用于把单个指标值关联到 trace/span ID
  // 方便实现 "指标 → trace" 的关联分析
  repeated Exemplar exemplars = 5;

  // 为该数据点设置的标志位,用于表示特殊状态,比如:
  // 1. 数据点是否有效(是否缺失值等)
  // 2. 数据点是否是预聚合值(是否需要特殊处理)
  uint32 flags = 8;
}
HistogramDataPoint
// 直方图数据点是时间序列中的单个数据点,用于描述直方图随时间变化的数值
// 直方图包含一组数值的汇总统计信息,可选择性地包含这些数值在不同桶中的分布情况。
// 若直方图包含数值分布信息,则必须同时定义"explicit_bounds"(显式边界)和"bucket_counts"(桶计数)字段。
// 若直方图不包含数值分布信息,则必须省略"explicit_bounds"和"bucket_counts"字段,此时仅能获取"count"(总数)和"sum"(总和)两个指标。
message HistogramDataPoint {
  reserved 1;

  // 同 NumberDataPoint
  repeated opentelemetry.proto.common.v1.KeyValue attributes = 9;
  fixed64 start_time_unix_nano = 2;
  fixed64 time_unix_nano = 3;

  // 样本总数,必须 >= 0
  // 如果提供桶分布,count 必须等于 bucket_counts 的元素和
  fixed64 count = 4;

  // 所有样本值的和(若 count=0 则 sum 必须为 0)
  // 应仅在测量非负的离散事件时填写(例如请求时延的正值、字节数等),并假定为单调(用于兼容 OpenMetrics)
  // see: https://github.com/prometheus/OpenMetrics/blob/v1.0.0/specification/OpenMetrics.md#histogram
  // 如果样本可能为负(例如带正负的值),不填写 sum
  optional double sum = 5;

  // 每个桶内的计数(数组);数组长度 = len(explicit_bounds) + 1(最后一个桶是 (+infty))
  // 若提供分布,bucket_counts 与 explicit_bounds 必须同时存在;若 bucket_counts 长度为 0,则 explicit_bounds 也必须为 0
  // 也就是:sum(bucket_counts) == count
  // 与 Prometheus 映射:对应多个 metric_bucket{le="<bound>"} 的值(上界为 explicit_bounds[i]),最后一个 le="+Inf" 为 bucket_counts[last]
  repeated fixed64 bucket_counts = 6;

  // 可选字段
  // 显式定义的桶上界数组(严格递增)
  // 上界包含(inclusive),最后桶为无限上界,与 bucket_counts 配合描述完整分布
  // 桶定义(索引 i):
  // 1. 当 i == 0 时,桶范围为 (-∞, explicit_bounds[0]]
  // 2. 当 0 < i < n 时,桶范围为 (explicit_bounds[i-1], explicit_bounds[i]]
  // 3. 当 i == n 时,桶范围为 (explicit_bounds[n-1], +∞)
  repeated double explicit_bounds = 7;

  // 同 NumberDataPoint
  repeated Exemplar exemplars = 8;
  uint32 flags = 10;

  // 窗口内的最小值((start_time, end_time] 区间)
  optional double min = 11;

  // 窗口内的最大值((start_time, end_time] 区间)
  optional double max = 12;
}
ExponentialHistogramDataPoint
// 是时间序列中的一个单独数据点,用于描述双精度数值的 ExponentialHistogram 随时间变化的取值
// 包含一组数值的汇总统计信息,并且可以选择性地包含这些数值在一组桶中的分布。
// 传统直方图(HistogramDataPoint)使用固定桶边界 (explicit_bounds)
// 它对传统 HistogramDataPoint 的改进:在大数量级范围和动态分布情况下,可以用更少内存、更高精度地表达样本分布。
message ExponentialHistogramDataPoint {
  // 同 NumberDataPoint
  repeated opentelemetry.proto.common.v1.KeyValue attributes = 1;
  fixed64 start_time_unix_nano = 2;
  fixed64 time_unix_nano = 3;

  // The number of values in the population. Must be
  // non-negative. This value must be equal to the sum of the "bucket_counts"
  // values in the positive and negative Buckets plus the "zero_count" field.
  fixed64 count = 4;

  // 同 HistogramDataPoint
  optional double sum = 5;

  // 每个桶的上下界按 base 的幂递增:base = 2^(2^-scale)
  // 桶索引为整数(可以负),其值代表区间 (base^index, base^(index+1)]
  // 越大的 scale → 越多桶(更精细),越小的 scale → 越少桶(更粗略)
  sint32 scale = 6;

  // 表示恰好为零,或在允许精度范围内被视为零值区域内的数值计数
  // 此桶用于存储无法通过标准指数公式表示的数值,以及被四舍五入为零的数值。
  // 有些值接近零,但因浮点精度或量化误差无法归入正/负桶,于是:
  // zero_count:零值或“足够接近零”的样本数量;
  // zero_threshold:零区间宽度,表示 [−threshold, +threshold] 被视为零。
  // 实现方案可认为零值桶的概率质量等于(zero_count / count)
  fixed64 zero_count = 7;

  // 正数范围的桶
  Buckets positive = 8;

  // 负数范围(按绝对值同样定义)的桶
  Buckets negative = 9;

  message Buckets {
    // 第一个桶的索引
    sint32 offset = 1;

    // 从 offset 开始的连续计数
    // 其中 bucket_counts[i] 表示索引为 (offset+i) 的桶的计数值
    // bucket_counts[i] 统计的是大于 base^(offset+i) 且小于等于 base^(offset+i+1) 的数值数量
    repeated uint64 bucket_counts = 2;
  }

  // 同 HistogramDataPoint
  uint32 flags = 10;
  repeated Exemplar exemplars = 11;
  optional double min = 12;
  optional double max = 13;

  // 可选择性设置以表示零值区域的宽度,零值区域定义为闭区间 [-ZeroThreshold, ZeroThreshold]
  // 如果 zero_threshold = 0.001,那么 [-0.001, +0.001] 的值都落在零桶
  double zero_threshold = 14;
}
SummaryDataPoint
// 是一种对连续观测值进行统计汇总的度量类型,常用于监控延迟、请求时长、处理时间等
// 和 Histogram 类似,它也是对分布进行描述,但它不需要固定 bucket,而是统计特定分位值。
// 它在一个时间段内记录:
// 1. 样本总数(count)
// 2. 样本总和(sum)
// 3. 特定分位点的数值(quantiles),例如:
//    p50(中位数)
//    p90(90% 的请求小于此值)
//    p99(99% 的请求小于此值)
message SummaryDataPoint {
  // 同 NumberDataPoint
  repeated opentelemetry.proto.common.v1.KeyValue attributes = 7;
  fixed64 start_time_unix_nano = 2;
  fixed64 time_unix_nano = 3;

  // 样本总数,大于等于0
  fixed64 count = 4;

  // 样本总和,如果 count 为 0 则此值也必须为 0
  double sum = 5;

  // 各个分位点的值(例如 0.5 → 200ms)
  // 表示分布在给定分位数处的数值。
  // 记录最小值和最大值时遵循以下约定:
  // - 1.0 分位数等同于观测到的最大值
  // - 0.0 分位数等同于观测到的最小值
  // 记录最小值和最大值时,分位点值必须非负。
  message ValueAtQuantile {
    // 分位点,范围 [0.0, 1.0]
    double quantile = 1;

    // 对应 quantile 的值(非负)
    double value = 2;
  }

  // (Optional) list of values at different quantiles of the distribution calculated
  // from the current snapshot. The quantiles must be strictly increasing.
  repeated ValueAtQuantile quantile_values = 6;

  // Flags that apply to this specific data point.  See DataPointFlags
  // for the available flags and their meaning.
  uint32 flags = 8;
}
模型详情
事件模型
是记录数据的地方,它的基础是仪器(Instruments),主要数据是指标数据点(时间戳+值),用于通过事件记录观测数据,然后将这些原始事件发送到其他系统之前以某种方式进行转换。
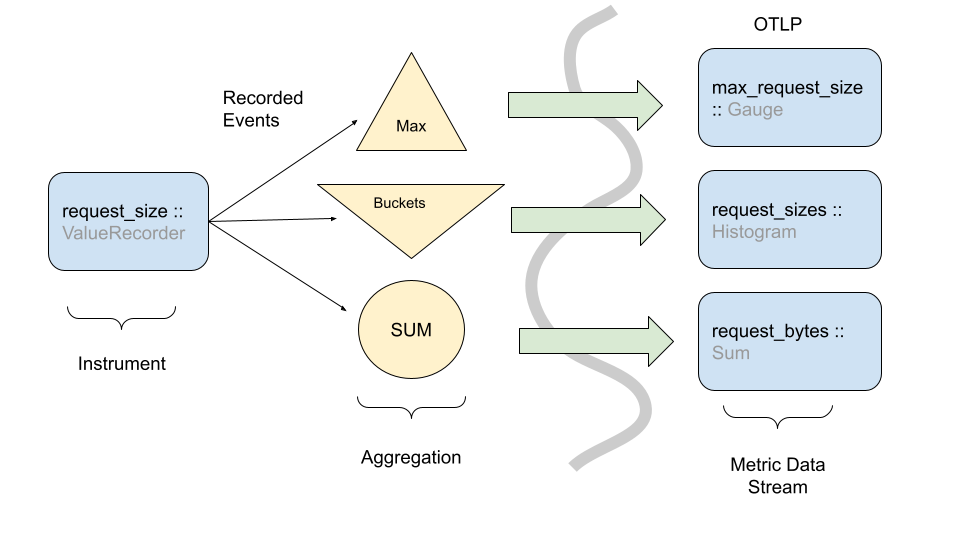
上图显示了仪器(Instruments)如何将事件转换为多种类型的指标流。
尽管观测事件数据可以直接报告给后端,但在生产环境中这是不建议的,因为可观测性系统中使用的数据量太大,但可用于遥测收集的网络等资源有限,所以在上报数据前最后要想办法降低指标基数,如采用直方图指标类型压缩指标等。
时间序列模型
表示后端如何存储指标数据。
时间序列由几个元数据属性组成的实体定义:
- 指标名称:Metric name
- 属性(维度):Attributes (dimensions)
- 数据点的值(整数、浮点等):Value type of the point (integer, floating point, etc)
- 计量单位:Unit of measurement
每个时间序列的主要数据都是按顺序排列的(时间戳、值)点,具有以下值类型之一:
- 计数器(单调,累计):Counter (Monotonic, Cumulative)
- 测量:Gauge
- 直方图:Histogram
- 指数直方图:Exponential Histogram
这个模型类似 Prometheus Remote Write 协议,但它并不是 OTLP 映射的唯一时间序列模型。
指标流模型
通过 OpenTelemetry 协议(OTLP)定义指标数据流在事件模型和时间序列存储之间传输与处理的方式。
指标流被分组为各个度量对象,由以下各项标识:
- 原始资源属性
Resource - 检测范围(例如,检测库名称、版本)
Scope - 指标流的名称
name
除名称外,指标对象还由以下属性定义:
- 数据点类型:Sum, Gauge, Histogram ExponentialHistogram, Summary
- 指标流的单位:unit
- 指标流的描述:description
- 内在数据点属性,如适用:聚合临时性、单调性
数据点类型、指标流的单位和内在数据点属性被认为是可识别的,而指标流的描述在本质上显然不是可识别的。
特定点的外在特性不被认为是可识别的;这些包括但不限于:
- 直方图数据点的桶边界
- 指数直方图数据点的刻度或桶计数。
Metric对象包含由属性集标识的各个流。在各个流中,点由一个或两个时间戳标识,细节因数据点类型而异。
在某些数据点类型(例如总和和仪表)中,允许数值点值发生变化;在这种情况下,相关的变化(即浮点与整数)不被认为是可识别的。
应用场景
Summary 与 Histogram 的对比
| 特性 | Summary | Histogram | ExponentialHistogram |
|---|---|---|---|
| 是否记录桶 | ❌ 否 | ✅ 显式桶 | ✅ 指数桶 |
| 是否有 exemplar | ❌ 无 | ✅ 有 | ✅ 有 |
| 是否能算分位数 | ✅ 已直接给出 | ✅ 可通过桶估算 | ✅ 可通过桶估算 |
| 是否能算任意 quantile | ❌ 只能用已有 quantiles | ✅ 可插值估算 | ✅ 可插值估算 |
| 是否能合并 | ❌ 很难准确合并 | ✅ 容易 | ✅ 容易 |
| 网络体积 | 较小 | 较大 | 中等 |
| 用途 | 上报分位统计结果 | 分布观测、trace 关联 | 高精度分布观测 |
典型使用场景
| 场景 | 推荐类型 |
|---|---|
| 请求延迟分位数监控(轻量) | ✅ Summary |
| 请求延迟分布分析 + Trace 跳转 | ✅ Histogram |
| 高频采样 + 跨数量级分布 | ✅ ExponentialHistogram |
| 跨节点聚合 / 联邦场景 | ❌ 不建议 Summary(用 Histogram) |
与 prometheus 类型对比
| Prometheus MetricType | 对应 OTLP Metric Type | OTLP message / aggregation | AggregationTemporality | 说明 |
|---|---|---|---|---|
METRIC_TYPE_COUNTER | Sum | Sum message | 通常为 CUMULATIVE | Counter 表示单调递增量,OTLP 的 Sum 设置 is_monotonic=true。 |
METRIC_TYPE_GAUGE | Gauge | Gauge message | 无需 temporality | Gauge 是瞬时测量值,对应 OTLP Gauge。 |
METRIC_TYPE_HISTOGRAM | Histogram | Histogram message | CUMULATIVE 或 DELTA | 传统桶式直方图,与 OTLP Histogram 完全对应。 |
METRIC_TYPE_GAUGEHISTOGRAM | Histogram | Histogram message | 通常为 DELTA 或“快照”式 | GaugeHistogram 在 Prometheus 中代表某一时刻的桶分布,OTLP 没有直接同名,但用 Histogram 表示瞬时分布。 |
METRIC_TYPE_SUMMARY | Summary | Summary message | 始终 CUMULATIVE | quantile(分位数)形式的度量,OTLP 直接支持 Summary。 |
METRIC_TYPE_INFO | Gauge(或 KeyValue attribute) | Gauge 或 Resource Attribute | 不适用 | Prometheus Info 通常是静态标签值,OTLP 推荐以 Resource 或 InstrumentationScope 属性表示。 |
METRIC_TYPE_STATESET | Gauge (boolean/int) | Gauge message | 瞬时 | StateSet 表示状态机(例如连接状态),可映射为多个布尔型 Gauge 或 Enum-like Gauge。 |
METRIC_TYPE_UNSPECIFIED | (无对应) | 无 | 无 | 未指定类型。应在数据导入时推断。 |
在 Go 语言中使用
同步或异步
仪器(Instruments)支持同步或异步导出指标值,且值类型为 int64 或 float64 两个类型。
同步行为
是在被调用时进行测量,测量在程序执行期间作为另一个调用来完成,就像执行其他业务函数一样。 这些测量值的聚合由配置的导出器定期导出。由于测量与导出值解耦,因此导出周期可能包含零个或多个聚合测量。
异步行为
是在 SDK 导出时才会调用创建提供给仪器(Instruments)的回调函数。 此回调为 SDK 提供了一个立即导出的指标值,异步仪器上的所有测量在每个输出周期执行一次。
异步主要在以下几种场景使用:
- 当更新指标值在函数内代价较高,并且不希望当前执行线程等待测量函数;
- 导出指标需要以与程序执行无关的频率发生(即当与请求生命周期联系在一起时,无法准确测量);
- 测量值没有已知的时间戳。
计数器 Counter
累积计数器,支持非负增量的仪器,也就是这些值永远不会减少(服务重启时重置为0),运行期间逐渐累加:
Int64Counter
Int64ObservableCounter

Float64Counter
Float64ObservableCounter
导出为 prometheus 格式时自动添加 “_count” 后缀。
计数器 UpDown
递增或者递减计数器,允许您观察递增或递减的累积值:
Int64UpDownCounter
Int64ObservableUpDownCounter

Float64UpDownCounter
Float64ObservableUpDownCounter
导出为 prometheus 格式时同 Gauge 类型。
测量 Gauge
比较随机值非累加,当只需要传达关于异步测量的最新数据时使用:
Int64ObservableGauge
Float64ObservableGauge
直方图 Histogram
当需要传达更多关于采集周期内进行的所有同步测量的信息时,应使用直方图:
Int64Histogram
Float64Histogram